
Технічне SEO це налаштування сайту на рівні коду та сервера, яке допомагає пошуковим роботам без помилок обійти сторінки, зрозуміти їх і додати в індекс. Чотири базові інструменти, що вирішують це завдання, файл robots.txt, карта sitemap.xml, канонічний тег і редиректи 301/302. Нижче розбираємо кожен: що він робить, який має синтаксис і які помилки найчастіше руйнують індексацію.
Головне за 30 секунд
- robots.txt керує обходом (краулінгом): підказує роботам, які розділи сканувати не потрібно.
- sitemap.xml: перелік важливих URL, який пришвидшує виявлення сторінок пошуковиком.
- Канонічний тег rel=”canonical” вказує головну версію сторінки та склеює дублі.
- Редирект 301: постійне перенесення, що передає вагу; 302: тимчасовий.
- Помилка в будь-якому з цих елементів здатна закрити сайт від індексації повністю, тому налаштування перевіряють після кожного релізу.
Краулінг та індексація: як пошуковик обробляє сайт
Перш ніж сторінка з’явиться в пошуку, вона проходить два етапи. Краулінг (сканування) це процес, коли робот пошукової системи переходить за посиланнями, завантажує HTML сторінок і виявляє нові URL. Індексація це наступний крок: система аналізує вміст і додає сторінку до своєї бази, після чого вона може показуватися у видачі.
Важливо розрізняти ці етапи: сторінку можна просканувати, але не проіндексувати наприклад, якщо вона позначена тегом noindex або визнана дублем. На великих сайтах відіграє роль краулінговий бюджет, обмежена кількість URL, яку робот готовий обійти за візит. Технічні інструменти нижче саме й допомагають спрямувати цей бюджет на важливі сторінки, а не витрачати його на службові.
robots.txt: що це і як налаштувати
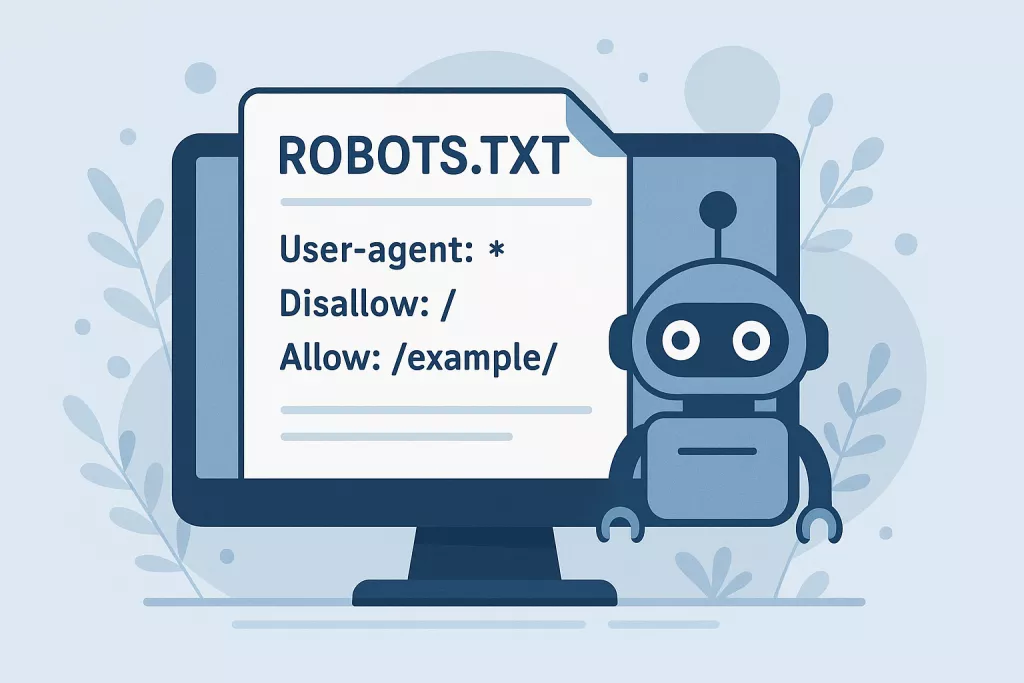
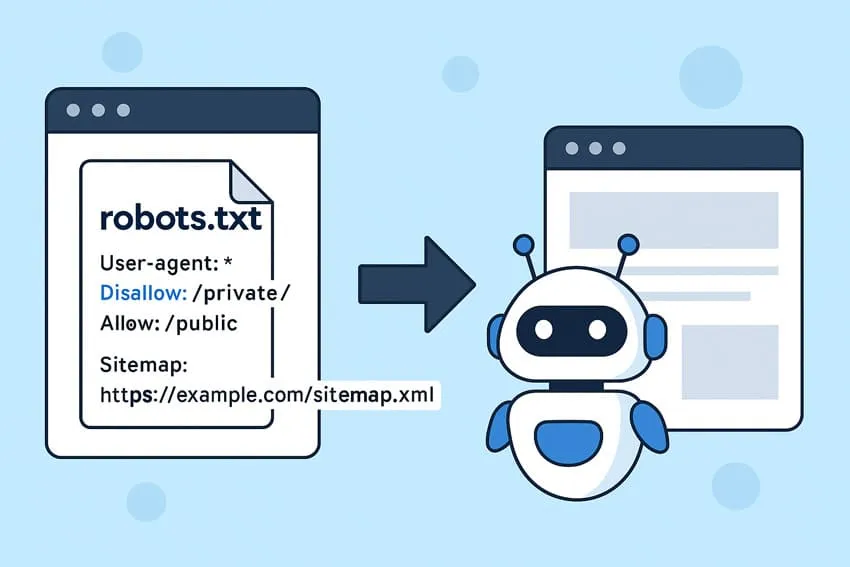
robots.txt це текстовий файл у корені сайту (доступний за адресою site.com/robots.txt), який повідомляє пошуковим роботам, які розділи обходити не потрібно. Він керує саме скануванням, а не індексацією і це принципова різниця.
Базовий синтаксис складається з директив User-agent (для якого робота правило), Disallow (що закрити), Allow (що дозволити) та вказівки на карту сайту:
User-agent: *
Disallow: /admin/
Disallow: /cart/
Allow: /
Sitemap: https://site.com/sitemap.xml
Часта й небезпечна помилка, залишити директиву Disallow: / (з одним слешем), яка закриває від обходу весь сайт. Так нерідко трапляється, коли robots.txt переносять з тестової версії на бойову. Ще один нюанс: закрита в robots.txt сторінка все одно може потрапити в індекс, якщо на неї ведуть зовнішні посилання. Щоб прибрати сторінку з пошуку, використовують мета-тег noindex або канонічний тег, а не robots.txt.
Sitemap.xml: карта сайту для робота
Sitemap.xml (карта сайту) це XML-файл з переліком важливих URL, які ви хочете бачити в індексі. Він не гарантує індексацію і не впливає безпосередньо на позиції, але пришвидшує виявлення сторінок особливо на нових і великих сайтах із глибокою вкладеністю.
Окрім адрес, карта може містити дату останньої зміни (lastmod), що допомагає роботу зрозуміти, які сторінки оновилися. Після створення карту надсилають у Google Search Console і вказують її адресу в robots.txt.
Типові помилки: додавати в sitemap сторінки, закриті від індексації (noindex), неіснуючі URL із кодом 404 чи редиректами, а також забути оновити карту після зміни структури сайту.
Канонічний тег: як прибрати дублі
Канонічний тег rel=”canonical” вказує пошуковику, яка версія сторінки головна, коли однаковий або майже однаковий контент доступний за кількома адресами. Він розміщується в секції <head>:
<link rel=”canonical” href=”https://site.com/tovar/” />
Канонікали вирішують проблему дублів, що виникають через фільтри та сортування в каталозі, UTM-мітки, пагінацію, версії з www і без, http та https. Хороша практика: ставити самопосилальний канонічний тег на кожній сторінці (сторінка вказує сама на себе).
Часті помилки: канонікал веде на сторінку з редиректом чи 404, усі сторінки сайту вказують на головну, канонікали конфліктують із тегом noindex. Докладніше про те, як знаходити й усувати дублі, у статті про дублі та канібалізацію.
Редиректи 301 і 302: у чому різниця
Редирект це автоматичне перенаправлення користувача й робота з одного URL на інший. Для SEO критично обрати правильний тип.
| Параметр | 301 (постійний) | 302 (тимчасовий) |
| Призначення | Сторінка переїхала назавжди | Сторінка тимчасово недоступна за цією адресою |
| Передача ваги | Передає майже всю посилальну вагу | Вага передається обмежено |
| Що з індексом | Старий URL замінюється новим | Старий URL залишається в індексі |
| Коли застосовувати | Зміна URL, склейка www, http→https, міграція | Акція, A/B-тест, техроботи |
Головна помилка це ставити 302 там, де потрібен 301 (при постійному переїзді): вага не склеюється, а стара адреса продовжує конкурувати з новою. Небезпечні й ланцюжки редиректів (URL A → B → C): вони витрачають краулінговий бюджет і втрачають частину ваги на кожному кроці. Про те, як переносити сайт без втрати позицій, варто почитати в гайді про міграцію сайту.
Типові помилки технічного SEO
- Disallow: / у robots.txt, випадково перенесений з тестового сервера, закриває весь сайт.
- Забутий мета-тег noindex після розробки: сторінки не потрапляють у пошук.
- Усі канонікали ведуть на головну: важливі сторінки випадають з індексу.
- Ланцюжки та цикли редиректів замість одного прямого 301.
- У sitemap потрапляють закриті, неіснуючі чи редиректні URL.
- Змішаний контент http/https після переходу на захищений протокол.
Як перевірити налаштування
Більшість проблем видно за півгодини, якщо знати, куди дивитися.
robots.txt: відкрийте site.com/robots.txt у браузері й переконайтеся, що важливі розділи не закриті; у Search Console є окремий інструмент перевірки.
Індексація у Google Search Console дивіться звіт «Індексування сторінок» і використовуйте інструмент перевірки URL. Якщо сторінки не індексуються, розберіть причини за чек-листом у статті про те, чому сайт не індексується.
Редиректи й канонікали це проженіть сайт краулером-скринером: він покаже всі ланцюжки редиректів, коди відповідей і канонічні теги масово. Sitemap: перевірте карту валідатором і переконайтеся, що вона відкривається й містить лише робочі URL.
Регулярну діагностику зручно вести через Search Console, як її налаштувати й читати звіти, описано в окремому гайді про налаштування Google Search Console.
Усі ці перевірки: частина технічного SEO-аудиту. Коли сторінок багато, відловлювати помилки вручну довго й легко щось пропустити: системніше замовити технічний SEO-аудит, який знайде закриті від індексації розділи, биті редиректи й дублі та видасть пріоритезований перелік правок.Хочете переконатися, що технічна частина сайту не заважає просуванню, залиште заявку на SEO-аудит, і ми перевіримо robots.txt, карту сайту, редиректи й канонікали за вашим проєктом. Зрозуміти місце технічки в загальній картині допомагає й оглядова стаття що таке лінкбілдинг.