


Техническое SEO — это настройка сайта на уровне кода и сервера, которая помогает поисковым роботам без ошибок обойти страницы, понять их и добавить в индекс. Четыре базовых инструмента, которые решают эту задачу, — файл robots.txt, карта sitemap.xml, канонический тег и редиректы 301/302. Ниже разбираем каждый: что он делает, как выглядит синтаксис и какие ошибки чаще всего роняют индексацию.
Коротко
- robots.txt управляет обходом (краулингом) — подсказывает роботам, какие разделы сканировать не нужно.
- sitemap.xml — список важных URL, который ускоряет обнаружение страниц поисковиком.
- Канонический тег rel=»canonical» указывает главную версию страницы и склеивает дубли.
- Редирект 301 — постоянный перенос и передаёт вес; 302 — временный.
- Ошибка в любом из этих элементов способна закрыть сайт от индексации целиком, поэтому настройки проверяют после каждого релиза.
Краулинг и индексация: как поисковик обрабатывает сайт
Прежде чем страница появится в поиске, она проходит два этапа. Краулинг (сканирование) — это процесс, когда робот поисковой системы переходит по ссылкам, скачивает HTML страниц и обнаруживает новые URL. Индексация — следующий шаг: система анализирует содержимое и добавляет страницу в свою базу, после чего она может показываться в выдаче.
Важно различать эти этапы: страница может быть просканирована, но не проиндексирована — например, если помечена тегом noindex или признана дублем. На больших сайтах играет роль краулинговый бюджет — ограниченное число URL, которое робот готов обойти за визит. Технические инструменты ниже как раз помогают направить этот бюджет на важные страницы и не тратить его на служебные.
robots.txt: что это и как настроить
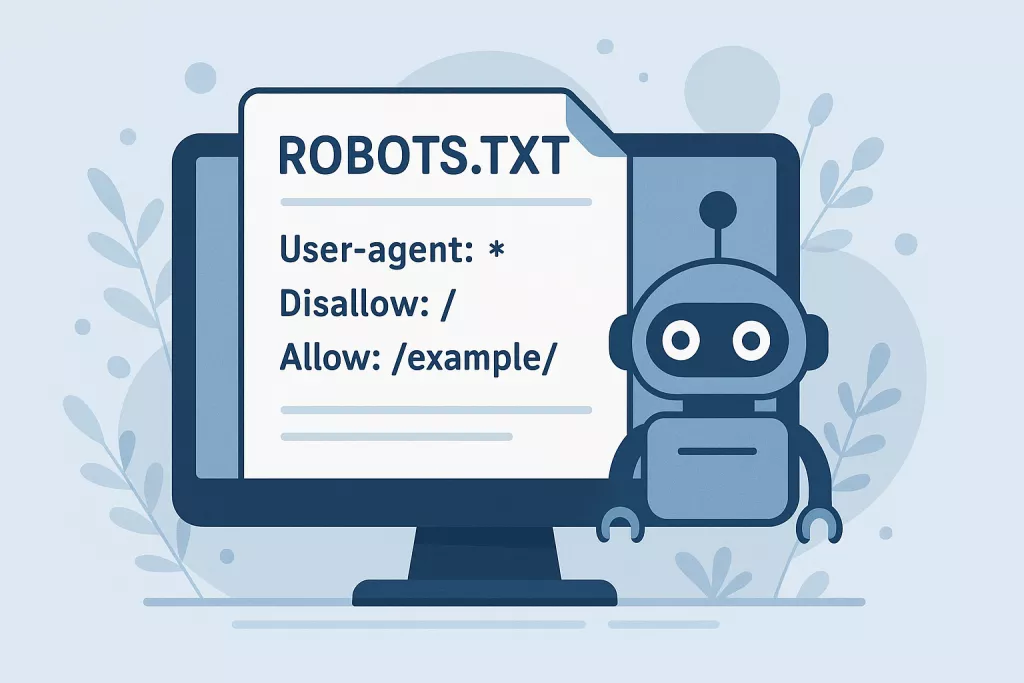
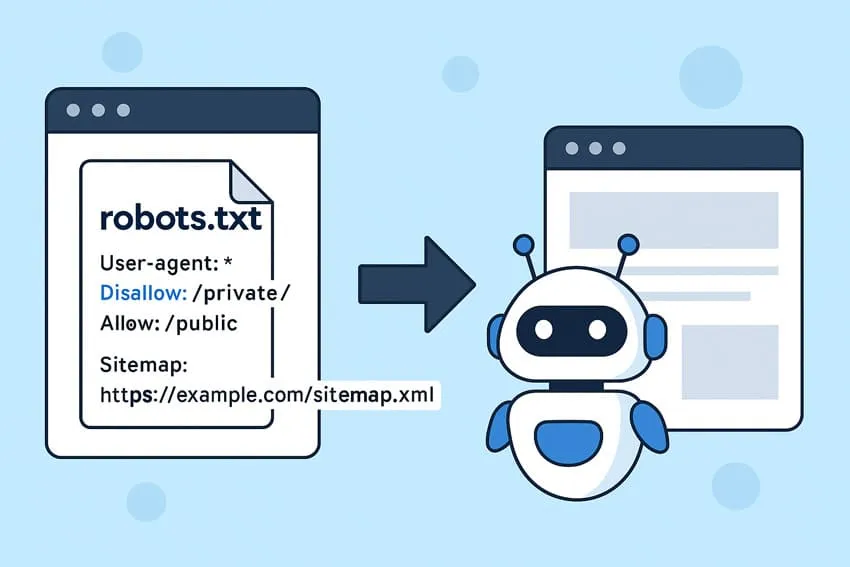
robots.txt — это текстовый файл в корне сайта (доступен по адресу site.com/robots.txt), который сообщает поисковым роботам, какие разделы обходить не нужно. Он управляет именно сканированием, а не индексацией — и это принципиальная разница.
Базовый синтаксис состоит из директив User-agent (для какого робота правило), Disallow (что закрыть), Allow (что разрешить) и указания на карту сайта:
User-agent: *
Disallow: /admin/
Disallow: /cart/
Allow: /
Sitemap: https://site.com/sitemap.xml
Частая и опасная ошибка — оставить директиву Disallow: / (с одним слешем), которая закрывает от обхода весь сайт. Так нередко случается, когда robots.txt переносят с тестовой версии на боевую. Ещё один нюанс: закрытая в robots.txt страница всё равно может попасть в индекс, если на неё ведут внешние ссылки. Чтобы убрать страницу из поиска, используют мета-тег noindex или канонический тег, а не robots.txt.
Sitemap.xml: карта сайта для робота
Sitemap.xml (карта сайта) — это XML-файл со списком важных URL, которые вы хотите видеть в индексе. Он не гарантирует индексацию и не влияет напрямую на позиции, но ускоряет обнаружение страниц — особенно на новых и крупных сайтах с глубокой вложенностью.
Кроме адресов, карта может содержать дату последнего изменения (lastmod), что помогает роботу понять, какие страницы обновились. После создания карту отправляют в Google Search Console и указывают её адрес в robots.txt.
Типичные ошибки: включать в sitemap страницы, закрытые от индексации (noindex), несуществующие URL с кодом 404 или редиректами, а также забыть обновить карту после изменения структуры сайта.
Канонический тег: как убрать дубли
Канонический тег rel=»canonical» указывает поисковику, какая версия страницы главная, когда одинаковый или почти одинаковый контент доступен по нескольким адресам. Он размещается в секции <head>:
<link rel=»canonical» href=»https://site.com/tovar/» />
Канониклы решают проблему дублей, которые возникают из-за фильтров и сортировок в каталоге, UTM-меток, пагинации, версий с www и без, http и https. Хорошая практика — ставить самоссылающийся канонический тег на каждой странице (страница указывает сама на себя).
Частые ошибки: канониникл ведёт на страницу с редиректом или 404, все страницы сайта указывают на главную, канониклы конфликтуют с тегом noindex. Подробнее о том, как находить и устранять дубли, — в статье про дубли и каннибализацию.
Редиректы 301 и 302: в чём разница
Редирект — это автоматическое перенаправление пользователя и робота с одного URL на другой. Для SEO критично выбрать правильный тип.
| Параметр | 301 (постоянный) | 302 (временный) |
| Назначение | Страница переехала навсегда | Страница временно недоступна по этому адресу |
| Передача веса | Передаёт почти весь ссылочный вес | Вес передаётся ограниченно |
| Что с индексом | Старый URL заменяется новым | Старый URL остаётся в индексе |
| Когда применять | Смена URL, склейка www, http→https, миграция | Акция, A/B-тест, техработы |
Главная ошибка — ставить 302 там, где нужен 301 (при постоянном переезде): вес не склеивается, а старый адрес продолжает конкурировать с новым. Опасны и цепочки редиректов (URL A → B → C): они тратят краулинговый бюджет и теряют часть веса на каждом шаге. О том, как переносить сайт без потери позиций, стоит почитать в гайде про миграцию сайта.
Типичные ошибки технического SEO
- Disallow: / в robots.txt, случайно перенесённый с тестового сервера, — закрывает весь сайт.
- Забытый мета-тег noindex после разработки — страницы не попадают в поиск.
- Все канониклы ведут на главную — важные страницы выпадают из индекса.
- Цепочки и циклы редиректов вместо одного прямого 301.
- В sitemap попадают закрытые, несуществующие или редиректные URL.
- Смешанный контент http/https после переезда на защищённый протокол.
Как проверить настройки
Большинство проблем видно за полчаса, если знать, куда смотреть.
robots.txt — откройте site.com/robots.txt в браузере и убедитесь, что важные разделы не закрыты; в Search Console есть отдельный инструмент проверки.
Индексация — в Google Search Console смотрите отчёт «Индексирование страниц» и используйте инструмент проверки URL. Если страницы не индексируются, разберите причины по чек-листу в статье о том, почему сайт не индексируется.
Редиректы и канониклы — прогоните сайт краулером-скринером: он покажет все цепочки редиректов, коды ответов и канонические теги массово. Sitemap — проверьте карту валидатором и убедитесь, что она открывается и содержит только рабочие URL.
Регулярную диагностику удобно вести через Search Console — как её настроить и читать отчёты, описано в отдельном гайде про настройку Google Search Console.
Все эти проверки — часть технического SEO-аудита. Когда страниц много, отлавливать ошибки вручную долго и легко что-то упустить: системнее заказать технический SEO-аудит, который найдёт закрытые от индексации разделы, битые редиректы и дубли и выдаст приоритизированный список правок.
Хотите убедиться, что техническая часть сайта не мешает продвижению, — оставьте заявку на SEO-аудит, и мы проверим robots.txt, карту сайта, редиректы и канониклы по вашему проекту. Понять место технички в общей картине помогает и обзорная статья что такое линкбилдинг.